TL;DR:在 OpenWrt 上用
apk add tailscale装的 Tailscale(1.98+,默认自己管理防火墙规则)会把net.ipv4.conf.all.src_valid_mark写成 1;而openwrt-nikki的 TPROXY 模式依赖「fwmark + 本地路由表」, 两者在内核fib_validate_source()里相撞,转发进来的包会被当作 martian source 静默丢弃 —— 现象是下游客户端全部断网、路由器本机完全正常、且没有任何日志和丢包计数器。 解决:tailscale set --netfilter-mode=off后重启(或把net.ipv4.conf.all.src_valid_mark覆盖为 0)。
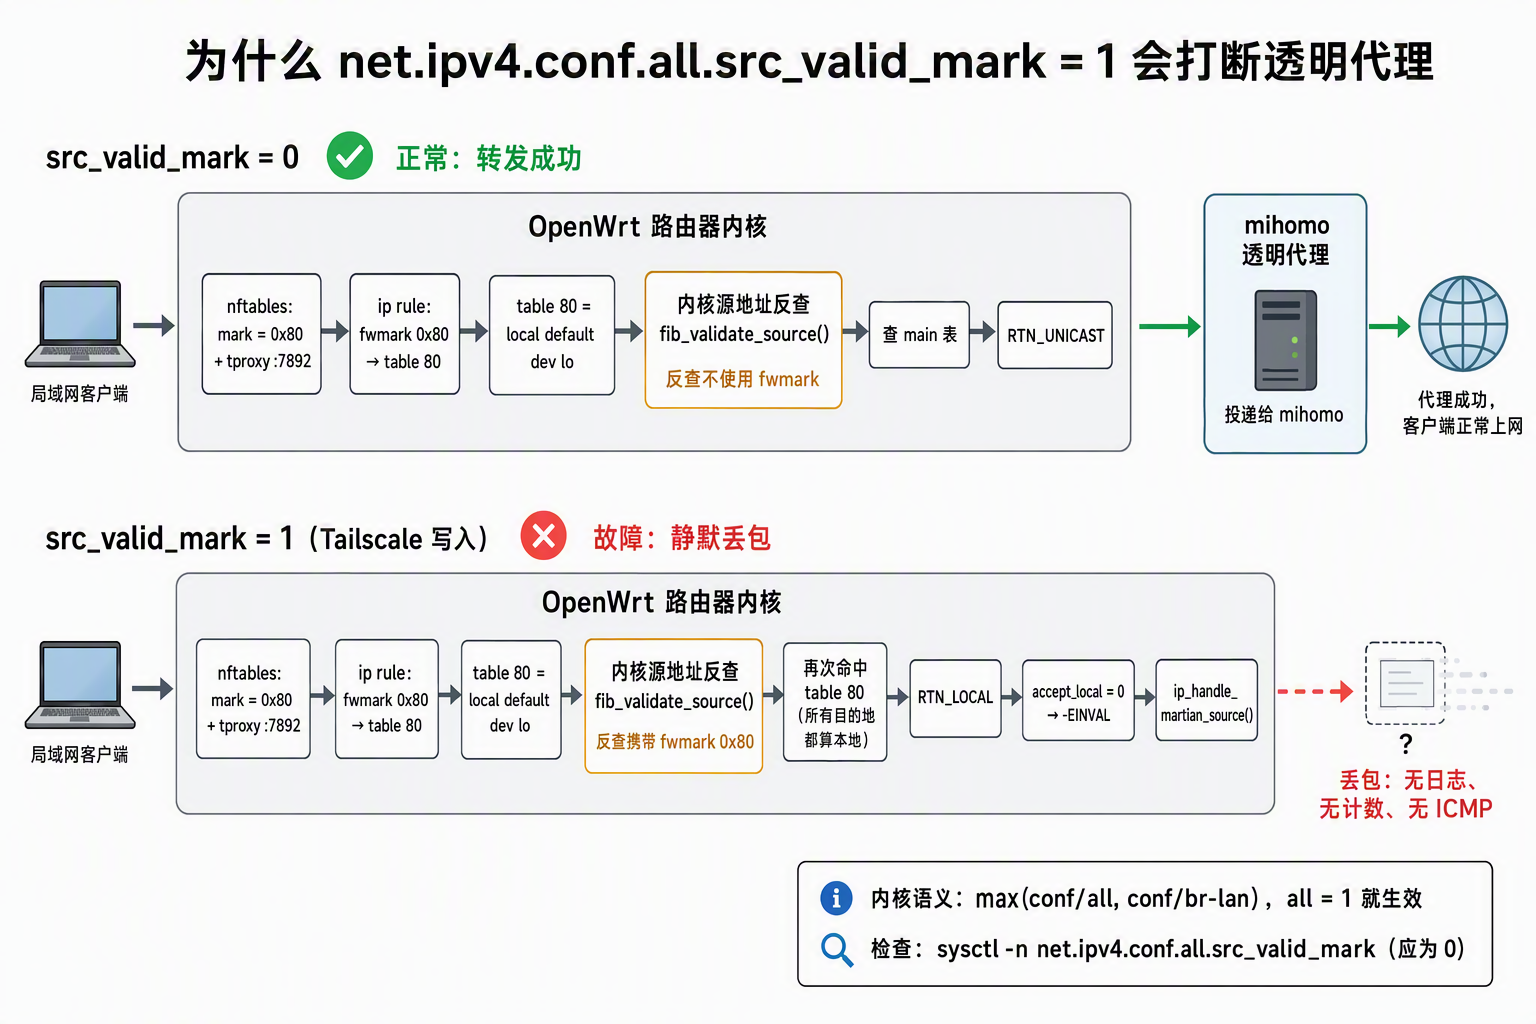
一图看懂:src_valid_mark = 0 时,源地址反查不携带 fwmark,落到 main 表的 RTN_UNICAST 路由 → 正常投递给 mihomo;
src_valid_mark = 1 时反查带着 fwmark 0x80 再次命中 table 80(“所有目的地都算本地”)→ RTN_LOCAL → -EINVAL
→ 被当作 martian source 静默丢弃。
现象
一台 OpenWrt 软路由(nikki + mihomo,透明代理用 TPROXY 模式)出现了很迷惑的情况:
- 局域网客户端:网页全挂(TCP/UDP 黑洞),但 DNS 能解析(返回 fake-ip)、
ping通; - 路由器本机:一切正常,
curl https://www.google.com/返回 200 —— 走的是同一个 TPROXY 监听器; service nikki stop立刻恢复;- 不是启动瞬态,稳态持续复现;
- 插件日志、核心日志、防火墙 drop 计数、内核 SNMP 计数全部正常,一点线索都没有。
环境:
| 故障机 | 对照机(同版本,正常) | |
|---|---|---|
| 系统 | OpenWrt 25.12.5 / kernel 6.12.94(arm64) | OpenWrt 24.10.6 / kernel 6.6.127(x86_64) |
| 透明代理 | nikki 2026.04.08-r1(TPROXY 模式) | nikki 2026.04.08-r1(同样 TPROXY) |
| 核心 | Mihomo Meta alpha-3cac869 | Mihomo Meta v1.19.25 |
| Tailscale | 1.98.3(OpenWrt 包,NetfilterMode=2) | 1.98.9(上游二进制,NetfilterMode=0) |
最小复现方式(重点)
只要满足这三条就能复现,和固件、架构、节点都无关:
- OpenWrt 上通过包管理器安装 Tailscale:
apk add tailscale(或 opkg),并且使用默认配置—— 1.98+ 默认会自己管理 netfilter 规则(tailscale debug prefs | grep NetfilterMode会看到 2); - 装 openwrt-nikki 并把透明代理设为 TPROXY(
tcp_mode=tproxy,lan_proxy=1); - 从局域网客户端访问任意落在代理端口列表里的端口(443/80…)。
此时:
sysctl -n net.ipv4.conf.all.src_valid_mark # → 1(Tailscale 写的)下游客户端全部超时;路由器本机正常;所有日志干净。 把这一项清零(或让 Tailscale 不再管理 netfilter),立刻恢复。
第一步:把常见的锅都排掉
用一台真实的局域网客户端做对照,把变量拆开:
| 测试 | 结果 | 结论 |
|---|---|---|
ping 网关 / ping 8.8.8.8 | 正常 | 不是链路、不是转发中断 |
dig @路由器 www.google.com | 返回 198.18.0.11(fake-ip) | DNS 劫持正常、mihomo 的 DNS 正常 |
TCP 223.5.5.5:53(不在代理端口列表) | 12/12 成功 | 不是 NAT/masq/防火墙问题 |
TCP 223.5.5.5:443(在代理端口列表) | 0/12 | 问题锁定在 TPROXY 这条路径上 |
路由器本机 curl 代理端口 | 200 | 节点、规则、上游 DNS 都没问题 |
结论:问题在「LAN → TPROXY → mihomo」这一段;而路由器本机走同一段却是好的。
第二步:找一个没人看的计数器
先看 nikki 生成的 nft 规则:
chain lan_tproxy {
    meta ... meta mark set meta mark & 0xffffff80 | 0x00000080
    tproxy to :7892 counter packets 6567 bytes 2351120 accept
}
注意 counter 写在 tproxy 之后:nftables 里 tproxy 若找不到透明套接字会 NFT_BREAK 并跳过该规则剩余表达式。
所以计数在涨 = 透明套接字查找成功,包确实被交给了 mihomo 的监听器。
但 mihomo 那边没有对应连接(Tcp:PassiveOpens 不增长、TcpExt:ListenDrops 为 0、conntrack 里查不到条目)。
于是问题变成:包在「已打 mark 并完成 tproxy」之后、到「投递到本机 socket」之前消失了,且不留痕迹。
这时唯一还在动的是这个计数器 —— 它藏在内核的 per-CPU 路由统计里:
# /proc/net/stat/rt_cache 的第 8 列 in_martian_src(十六进制)
tail -n +2 /proc/net/stat/rt_cache | while read -r e a b c d f g h rest; do
printf "%d\n" "0x$h"; done | awk '{s+=$1} END{print s}'| 状态 | 15~30 秒增量 |
|---|---|
| nikki 关闭 | +0 |
| nikki 开启(安静) | +124 / 22s |
| nikki 开启 + 12 个 SYN | +373 / 28s |
包被当作 martian source 丢掉了。 而它只被内核这一处增加:
/* net/ipv4/route.c */
static void ip_handle_martian_source(...)
{
    RT_CACHE_STAT_INC(in_martian_src);            /* 只加这个内部计数 */
#ifdef CONFIG_IP_ROUTE_VERBOSE
    if (IN_DEV_LOG_MARTIANS(in_dev) && net_ratelimit()) { ... }   /* log_martians 默认 0 → 不打日志 */
#endif
}
不计 SNMP、不打日志、不回 ICMP —— 这就是”静默”的来源,也是这类问题最难查的原因。
第三步:追到内核里 mark 与源地址校验的冲突
内核在把包投递给本机之前,会做一次「源地址反查」(防伪造源地址):
/* net/ipv4/fib_frontend.c */
int fib_validate_source(...)
{
    int r = secpath_exists(skb) ? 0 : IN_DEV_RPFILTER(idev);
    if (!r && !fib_num_tclassid_users(net) && (dev->ifindex != oif || ...)) {
        if (IN_DEV_ACCEPT_LOCAL(idev)) goto ok;
        if (net->ipv4.fib_has_custom_local_routes || fib4_has_custom_rules(net))
            goto full_check;        /* ← TPROXY 装了自定义 ip rule + local 路由,必走这里 */
        ...
    }
full_check:
    return __fib_validate_source(...);
}
关键在 __fib_validate_source() 的第一行:
fl4.flowi4_mark = IN_DEV_SRC_VMARK(idev) ? skb->mark : 0;   /* ← 反查也带上了包的 mark! */
if (fib_lookup(net, &fl4, &res, 0)) goto last_resort;
if (res.type != RTN_UNICAST &&
    (res.type != RTN_LOCAL || !IN_DEV_ACCEPT_LOCAL(idev)))
        goto e_inval;                                       /* ← -EINVAL → martian source → 丢包 */
TPROXY 的标准配置是:
ip rule add pref 1024 fwmark 0x80/0xff lookup 80
ip route add local default dev lo table 80     # 这张表里"所有目的地都算本地"
于是:
- 包本身的查表(mark=0x80)命中 table 80 →
RTN_LOCAL→ 本该投递给本机 ✔ - 紧接着的”源地址反查”带着同一个 mark,去查”客户端源地址”的路由 → 同样命中 table 80 →
又是一条
local路由 → 判定RTN_LOCAL→ 进入e_inval→ 被当作 martian source 丢掉 ✘
那 mark 到底会不会参与反查?由 src_valid_mark 决定,而它的语义是 「或」/max:
#define IN_DEV_SRC_VMARK(in_dev)   IN_DEV_ORCONF((in_dev), SRC_VMARK)
#define IN_DEV_ORCONF(in_dev,attr) (IPV4_DEVCONF_ALL_RO(net,attr) || IN_DEV_CONF_GET(in_dev,attr))内核文档(Documentation/networking/ip-sysctl.rst)写得很清楚:
src_valid_mark- BOOLEAN
- 0 - The fwmark of the packet is not included in reverse path route lookup. This allows for asymmetric routing configurations utilizing the fwmark in only one direction, e.g., transparent proxying.
- 1 - … The max value from conf/{all,interface}/src_valid_mark is used.
所以即使 br-lan.src_valid_mark=0,只要 conf/all 是 1 就依然生效 —— 这是最容易看错的一点,
我第一次排查时就因为 br-lan 是 0 而误判”这个开关与我无关”。
顺便解释了「为什么路由器本机正常」:本机流量在 OUTPUT 阶段就已经定好了 skb_dst(复用 lo 的本地路由),
根本不会进入这条源地址校验。
第四步:是谁把 src_valid_mark 写成了 1
对照机(同版本 nikki/mihomo、同 TPROXY 配置、正常工作)给出答案:
| 故障机 | 对照机 | |
|---|---|---|
all.src_valid_mark | 1 | 0 |
br-lan.src_valid_mark / accept_local / ip_nonlocal_bind | 0 / 0 / 0 | 0 / 0 / 0 |
| ip rule + table 80 + nft 规则 | 完全相同 | 完全相同 |
tailscale prefs.NetfilterMode | 2 (on) | 0 (off) |
| tailscale 是否安装自己的防火墙规则 | 装(ts-input/ts-forward/…) | 一个都没装 |
| tailscaled 日志 | router: enabling connmark-based rp_filter workaround | 无此行 |
| 局域网 38MB 下载 | 0 字节 | 38,396,690 B @ 8.3 MB/s |
Tailscale 源码把因果写得很直白(wgengine/router/osrouter/router_linux.go):
case netfilterOn:
    r.logf("enabling connmark-based rp_filter workaround")
    ...
    // Enable src_valid_mark so the kernel uses the packet's fwmark
    // during the rp_filter reverse-path check. Without this, the
    // connmark restore in mangle/PREROUTING is ineffective ...
    if err := writeSysctl("net.ipv4.conf.all.src_valid_mark", "1"); err != nil { ... }
default:  /* off / nodivert */
    r.logf("disabling connmark-based rp_filter workaround")
    r.nfr.DelConnmarkSaveRule()
    r.connmarkEnabled = false        // 注意:没有 writeSysctl(..., "0")
因果实测:
$ sysctl -w net.ipv4.conf.all.src_valid_mark=0
$ /etc/init.d/tailscale restart
t+5s: svm=1        ← 5 秒内被设回
日志 : router: enabling connmark-based rp_filter workaround
所以这不是 nikki 的 bug,也不是”某个 Tailscale 版本有 bug”:
Tailscale 为了自己 connmark + rp_filter 的兼容性,需要在 all 上写 1(对它的 exit node / 子网路由有意义),
而 TPROXY 在内核语义上需要 0 —— 两者天然互斥。对照机之所以没事,
是它很久以前被设成 --netfilter-mode=off 并持久化在 prefs 里(NetfilterMode=0),因此不装规则、也不写这个 sysctl。
一句话记住:
apk add装的 Tailscale + TPROXY 的 openwrt-nikki = 这个坑。
解决方案
A. 让 Tailscale 不再管理 netfilter(等价于对照机,推荐)
tailscale set --netfilter-mode=off             # 写进 prefs,重启后依然生效
sysctl -w net.ipv4.conf.all.src_valid_mark=0   # off 本身不会把它写回 0
# 或者直接 reboot:off 之后没人再写它,重启即恢复默认 0
off只删规则、不会把 sysctl 清回 0(见上面源码default:分支),所以必须重启或手动清一次。 关闭 Tailscale 自管规则后,tailnet 访问依赖 fw4 里的tailscalezone(确认 input 放行即可)。
B. 保留 Tailscale 现状,只覆盖这一个 sysctl(要持久化)
sysctl -w net.ipv4.conf.all.src_valid_mark=0
# tailscaled 在 S80 启动且每次启动都会写回 1 → 必须在它之后,并加兜底
sed -i 's#^exit 0#sysctl -q -w net.ipv4.conf.all.src_valid_mark=0\nexit 0#' /etc/rc.local
echo '*/2 * * * * /sbin/sysctl -q -w net.ipv4.conf.all.src_valid_mark=0' >> /etc/crontabs/root
/etc/init.d/cron restart && /etc/init.d/nikki restart
C. 完全不动 Tailscale:TCP 用 redirect,UDP 用 tproxy
uci set nikki.proxy.tcp_mode='redirect'   # DNAT,不需要 mark/本地路由,天然避开冲突
uci set nikki.proxy.udp_mode='tproxy'     # UDP 仍走 tproxy(UDP 不受这条校验影响)
uci commit nikki
sysctl -w net.ipv4.conf.br-lan.accept_local=1   # UDP tproxy 也需要过同一条校验
验收(三条,缺一不可)
sysctl -n net.ipv4.conf.all.src_valid_mark                 # 必须 0
tailscale debug prefs | grep NetfilterMode                  # 期望 0
# 从局域网客户端做一次大文件下载(不要只看 ping、也不要只看能不能握手)
curl -s -o /dev/null -m 30 -w 'size=%{size_download} speed=%{speed_download}\n' \
  https://mirrors.aliyun.com/ubuntu/ls-lR.gz                # 期望 ~38MB
修复后的其它侧证:nft 里 lan_tproxy 计数持续增长(几十秒内 12,780 → 20,758);
/proc/net/nf_conntrack 出现无 SNAT 的 tproxy 条目且带真实字节,例如 38MB 那条:
src=<client> dst=119.167.135.49 sport=53718 dport=443 packets=3181  bytes=166279
src=119.167.135.49 dst=<client>  sport=443  dport=53718 packets=1876 bytes=38621230
这次省下时间的几条排查方法论
- 分清「路由器本机」和「下游」两条路径:本机流量在 OUTPUT 已定
skb_dst,很多校验根本不会走; 下游流量才会经过fib_validate_source()这类检查。“本机好、下游坏”往往就出在这里。 - 别相信”日志没报错”:
ip_handle_martian_source()这类路径不计 SNMP、默认不打日志。 遇到”包凭空消失”,先去找内核内部计数器:/proc/net/stat/rt_cache(路由)、/proc/net/netstat的TcpExt、/proc/net/snmp、conntrack -S。 - 判断 TPROXY 是否真的工作,用这两个判据:
- ✅ conntrack 里出现无 SNAT 的条目(回复方向的目的地就是客户端本身)+ 真实字节数;
- ✅ 局域网客户端做一次大文件下载(对照机与修复后都是
38,396,690 B)。 - ❌
nc -z <ip> <被代理端口>:监听套接字会先回 SYN-ACK,connect()成功不代表数据能通 (故障时 12/12”成功”,对照机反而 0/6)。 - ❌ 只看 mihomo 日志:故障时它确实什么都没有(连接根本没到它),不能反推”日志正常=没问题”。
- 读内核宏/文档确认语义:
max(all, iface)、ORCONF/ANDCONF/MAXCONF这类宏, 这次就是br-lan=0却因all=1生效导致的误判。 - 跨机对照最快:同版本软件一台好一台坏时,把两台的
sysctl、ip rule、nft规则、日志逐项 diff, 差异项往往就是根因。 - 调试会掐断自己网络的设备时,先用看门狗(到点自动回滚)+ detached 脚本(结束时无条件还原), 自己”睡过”整个断网窗口再取数据 —— 即使代理侧失控也能自愈。
参考
- 内核文档
Documentation/networking/ip-sysctl.rst(src_valid_mark/accept_local/rp_filter) - 内核源码
net/ipv4/fib_frontend.c(IN_DEV_*CONF宏、fib_validate_source/__fib_validate_source)、net/ipv4/route.c(ip_handle_martian_source)、net/ipv4/ip_forward.c - Tailscale 源码
wgengine/router/osrouter/router_linux.go(connmark workaround →src_valid_mark=1) - 上游 issue:
- nikki:https://github.com/nikkinikki-org/OpenWrt-nikki/issues/903
- Tailscale:https://github.com/tailscale/tailscale/issues/19796(1.98.x 写
all.src_valid_mark=1破坏 fwmark 策略路由)
- 上游文档改动:nikki README https://github.com/nikkinikki-org/OpenWrt-nikki/pull/904、 mihomo 文档(TPROXY 前置要求)https://github.com/MetaCubeX/Meta-Docs/pull/214
评论
使用 GitHub 账号登录后留言。
评论将在滚动到此处时加载。
评论无法显示?前往 GitHub 讨论区 ↗